助力 Python 老司机都开火箭了!Cython 实现百倍加速 NLP (助力油和液压油一样吗)
c++ython 助力 Python NLP 实现百倍加速" src="https://www.gpxz.com/zdmsl_image/article/20241203204528_93505.jpg" loading="lazy">
SpaceX 猎鹰重型发射器,版权归
在去年我们发布了用 Python 实现的 基于神经网络的相互引用解析包(Neural coreference resolution package) 之后,在社区中获得了惊人数量的反馈,许多人开始将该解析包用到各种各样的应用中,有一些应用场景甚至已经超出了我们原本设计的对话框用例(Dialog use-case)。
后来我们发现,虽然这个解析包对于对话框消息而言,解析速度完全够用,但如果要解析更大篇幅的文章就显得太慢了。
因此我决定要深入探索解决方案,并最终开发出了 NeuralCoref v3.0 。这个版本比之前(每秒解析几千字)的要快出百倍,同时还保证了相同的准确性,当然,它依然易于使用,也符合 Python 库的生态环境。
在本篇文章中,我想向大家分享我在开发 NeuralCoref v3.0 过程中学到的一些经验,尤其将涉及:
我的标题其实有点作弊,因为我实际上要谈论的是 Python,同时也要介绍一些 Cython 的特性。不过你知道吗?Cython 属于 Python 的超集,所以不要让它吓跑了!
以下给出了一些可能需要采用这种加速策略的场景:
百倍加速第一步:代码剖析
你需要知道的第一件事情是,你的大部分代码在纯 Python 环境下可能都运行良好,但是其中存在一些瓶颈函数(Bottlenecks functions),一旦你能给予它们更多的「关照」,你的程序将获得几个数量级的提速。
所以你应该从剖析自己的 Python 代码开始,找出那些低效模块。其中一种方法就是使用:
你很可能会发现低效的原因是因为一些循环控制,或者你使用神经网络时引入了过多的 Numpy 数组操作(我不会花费时间在这里介绍 Numpy,这个问题已经有 太多文章 进行了讨论)。
那么我们该如何来加速循环呢?
在 Pyhthon 中加入 Cython 加速循环计算

让我们通过一个简单的例子来解决这个问题。假设有一堆矩形,我们将它们存储成一个由 Python 对象(例如对象实例)构成的列表。我们的模块的主要功能是对该列表进行迭代运算,从而统计出有多少个矩形的面积是大于所设定阈值的。
我们的 Python 模块非常简单:
其中 check_rectangles 函数就是我们程序的瓶颈!它对一个很长的 Python 对象列表进行迭代,而这一过程会相当缓慢,因为 Python 解释器在每次迭代中都需要做很多工作(查找类中的方法、参数的打包和解包、调用 Python API 等等)。
Cython 语言是 Python 的一个超集,它包含有两种类型的对象:
定义这种循环最直接的一种方法就是,定义一个包含有计算过程中我们所需要用到的所有对象的结构体。具体而言,在本例中就是矩形的长度和宽度。
然后我们可以将矩形对象列表存储到 C 的结构数组中,再将数组传递给 check_rectangles 函数。这个函数现在将接收一个 C 数组作为输入,此外我们还使用关键字取代了(注意:也可以用于定义 Cython C 对象)将函数定义为一个 Cython 函数。
这里是 Cython 版本的模块程序:
这里我们使用了原生的 C 数组指针,不过你还有其它选择,特别是 C++ 中诸如向量、二元组、队列这样的结构体 。在这段程序中,我还使用了一个来自提供的内存管理对象,它可以避免手动释放所申请的 C 数组内存空间。当不再需要使用 Pool 中的对象时,它将自动释放该对象所占用的内存空间。
有很多办法来测试、编译和发布 Cython 代码。Cython 甚至可以像 Python 一样 直接用于 Jupyter Notebook 中。
通过 pip install cython 命令安装 Cython。

使用 %load_ext Cython 指令在 Jupyter notebook 中加载 Cython 扩展。
然后通过指令,我们就可以像 Python 一样在 Jupyter notebook 中使用 Cython。
如果在执行 Cython 代码的时候遇到了编译错误,请检查 Jupyter 终端的完整输出信息。
大多数情况下可能都是因为在之后遗漏了标签(比如当你使用 spaCy Cython 接口时)。如果编译器报出了关于 Numpy 的错误,那就是遗漏了 import numpy 。
正如我在一开始就提到的,请好好阅读 这份 Jupyter notebook 和这篇文章,它包含了我们在 Jupyter 中讨论到的所有示例。
Cython 代码的文件后缀是,这些文件将被 Cython 编译器编译成 C 或 C++ 文件,再进一步地被 C 编译器编译成字节码文件。最终 Python 解释器将能够调用这些字节码文件。
你也可以使用将一个 .pyx 文件直接加载到 Python 程序中:
你也可以将自己的 Cython 代码作为 Python 包构建,然后像正常的 Python 包一样将其导入或者发布,更多细节请参考 这里 。不过这种做法需要花费更多的时间,特别是你需要让 Cython 包能够在所有的平台上运行。如果你需要一个参考样例,不妨看看 spaCy 的安装脚本 。
在我们开始优化自然语言处理任务之前,还是先快速介绍一下、和这三个关键字。它们是你开始学会使用 Cython 之前需要掌握的最主要的知识。
你可以在 Cython 程序中使用三种类型的函数:
关键字的另一个用途就是,在代码中表明某一个对象是 Cython C/C++ 对象。所以除非你在代码中使用声明对象,否则这些对象都会被解释器当做 Python 对象(这会导致访问速度变慢)。
使用 Cython 和 spaCy 加速自然语言处理
这一切看起来都很好,但是......我们到现在都还没开始涉及优化自然语言处理任务!没有字符串操作,没有 unicode 编码,也没有我们在自然语言处理中所使用的妙招。
此外 Cython 的官方文档甚至 建议不要使用 C 语言类型的字符串:
那么当我们在操作字符串时,要如何在 Cython 中设计一个更加高效的循环呢?
spaCy 处理该问题的做法就非常地明智。
将所有的字符串转换为 64 位哈希码
spaCy 中所有的 unicode 字符串(一个标记的文本、它的小写形式文本、它的引理形式、POS 标记标签、解析树依赖标签、命名实体标签等等)都被存储在一个称为 StringStore 的数据结构中,它通过一个 64 位哈希码 进行索引,例如 C 类型的。

StringStore 对象实现了 Python unicode 字符串与 64 位哈希码之前的查找映射。
它可以从 spaCy 的任何地方和任意对象进行访问,例如 npl.vocab.strings 、 doc.vocab.strings 或者 span.doc.vocab.string 。
当某一个模块需要在某些标记(tokens)上获得更快的处理速度时,你可以使用 C 语言类型的 64 位哈希码代替字符串来实现。调用 StringStore 查找表将返回与该哈希码相关联的 Python unicode 字符串。
但是 spaCy 能做的可不仅仅只有这些,它还允许我们访问文档和词汇表完全填充的 C 语言类型结构,我们可以在 Cython 循环中使用这些结构,而不必去构建自己的结构。
与 spaCy 文档有关的主要数据结构是 Doc 对象,该对象拥有经过处理的字符串的标记序列(“words”)以及 C 语言类型对象中的所有标注,称为,它是一个 TokenC 的结构数组。
TokenC 结构包含了我们需要的关于每个标记的所有信息。这种信息被存储成 64 位哈希码,它可以与我们刚刚所见到的 unicode 字符串进行重新关联。
如果想要准确地了解这些漂亮的 C 结构中的内容,可以查看新建的 spaCy 的 Cython API 文档 。
接下来看一个简单的自然语言处理的例子。
假设现在有一个文本文档的数据集需要分析。
我写了一个脚本用于创建一个包含有 10 份文档的列表,每份文档都大概含有 17 万个单词,采用 spaCy 进行分析。当然我们也可以对 17 万份文档(每份文档包含 10 个单词)进行分析,但是这样做会导致创建的过程非常慢,所以我们还是选择了 10 份文档。
我们想要在这个数据集上展开某些自然语言处理任务。例如,我们可以统计数据集中单词「run」作为名词出现的次数(例如,被 spaCy 标记为「NN」词性标签)。
采用 Python 循环来实现上述分析过程非常简单和直观:
但是这个版本的代码运行起来非常慢!这段代码在我的笔记本上需要运行 1.4 秒才能获得答案。如果我们的数据集中包含有数以百万计的文档,为了获得答案,我们也许需要花费超过一天的时间。
我们也许能够采用多线程来实现加速,但是在 Python 中这种做法并不是那么明智 ,因为你还需要处理 全局解释器锁(GIL) 。另外请注意,Cython 也可以 使用多线程 !Cython 在后台可以直接调用 OpenMP。不过我没有时间在这里讨论并行性,所以请查看 此链接 以了解更多详情。
现在让我们尝试使用 spaCy 和 Cython 来加速 Python 代码。
首先需要考虑好数据结构,我们需要一个 C 类型的数组来存储数据,需要指针来指向每个文档的 TokenC 数组。我们还需要将测试字符(「run」和「NN」)转成 64 位哈希码。
当所有需要处理的数据都变成了 C 类型对象,我们就可以以纯 C 语言的速度对数据集进行迭代。
这里展示了这个例子被转换成 Cython 和 spaCy 的实现:
代码有点长,因为我们必须在调用 Cython 函数之前在 main_nlp_fast 中声明和填充 C 结构。
这串代码虽然变长了,但是运行效率却更高!在我的 Jupyter notebook上,这串 Cython 代码只运行了大概 20 毫秒,比之前的纯 Python 循环快了大概 80 倍。
使用 Jupyter notebook 单元编写模块的速度很可观,它可以与其它 Python 模块和函数自然地连接:在 20 毫秒内扫描大约 170 万个单词,这意味着我们每秒能够处理高达 8 千万个单词。
对使用 Cython 进行自然语言处理加速的介绍到此为止,希望大家能喜欢它。
关于 Cython 还有很多其它的东西可以介绍,但是已经超出了这篇文章的初衷(这篇文章只是作为简介)。从现在开始,最好的资料也许是这份综述性的 Cython 教程 和介绍 spaCy 自然语言处理的 Cython 页面 。
如果你还想要获得更多类似的内容,请记得给我们点赞哟!
Via 100 Times Faster Natural Language Processing in Python ,雷锋网 AI 研习社编译整理
版权文章,未经授权禁止转载。详情见 转载须知 。
本文地址: https://www.gpxz.com/article/41195.html


PR值全称为PageRank(网页级别),取自Google的创始人LarryPage。它是Google排名运算法则(排名公式)的一部分,PR查询可以根据域名查出对应网站(可查内页)的PR。

LOL网址导航网是专业的上网导航网站,精心收录各类优质热门网站信息,同时提供天气、快递、违章等各种生活便民查询工具网址,为您提供安全便捷的上网导航服务,现已被众多网友设为上网主页,网址导航大全首选LOL网址导航.

上海宇科08年成立至今,提供注册公司,代理记账,营业执照代理,上海注册公司找宇科,咨询热线021-62626255,上海公司注册一站式服务。

json格式化xml格式化md5base64二维码生成url编码unicode编码时间戳ip

身体健康网不定时更新为带给大家实用的健康行业信息,包括:

贵州梦雨影文化传媒有限公司主要承接各类影视制作,包括电视专题片、摄影摄像、微电影、企业广告宣传短片等。我们的目标:为客户打造前所未有的震憾视觉;我们的理念:提交的首先感动自已的作品。
76bb游戏网致力成为专业的网络游戏门户站,您可以在这里获得最新且专业的游戏新闻资讯、游戏攻略,还有更多好玩的游戏推荐、游戏排行等游戏相关内容。

公司注册、公司变更、代理记账、财务咨询、知识产权润锡咨询


万读简帛动漫音乐
随想阁楼
天津诺佳程工程管理咨询有限公司主要从事代写标书、代做预算、工程造价、招投标代理、项目报告编写

有关疯狂的手游有哪些推荐2022,玩游戏就应该肆意地释放自己的激情,在现实当中难以完成的挑战,在游戏当中就能够尽情地疯狂一把,这些释放自己压力的休闲游戏,可以给玩家带来激情,再或者让玩家抓狂到想摔键盘,疯狂游戏没有定式,能够让你疯狂就足够了,下面就一起来看看吧,1、,疯狂搬砖,疯狂搬砖,是款以搬砖赚钱为主要目的的放置建造类手游,实则...。

阅读公司资料,了解加盟政策,调查本地市场,前往总部进行实地考察,确定加盟意向,通过各方面的综合考量,确定了加盟意向后,就需要向总部提出加盟申请,并按照总部的要求,详细如实的填写加盟申请表,双方达成共识,加盟商与总部就可以正式签订加盟合同,同时加盟商需要向总部交纳一些费用,签订合同后,公司协助加盟商进行店面选址,并出店面选址评估报告,加...。

EricWard是一位MIT毕业生,一直以来,他都想从事太空行业,他说,在这个行业中,企业家们都对太空饱含热情,对解决难题满怀激动,在MIT医学工程专业毕业之后,Ward加入NASA和马丁航空公司,希望他能终生在这家大型的太空公司工作,但是在过去的十年中,他目睹了新一代太空公司的兴起,维珍银河、蓝色起源、SpaceX等,他说,E...。

要想加盟一家蛋糕店,申请人不仅要选择对加盟品牌,还要知道蛋糕店如何加盟,今天,小编就来为大家解答这个疑惑,希望接下来的介绍,能对大家在进行蛋糕加盟时,起到一定的帮助,蛋糕店如何加盟时,先来教大家应该怎样选择蛋糕品牌,如今,市面上的蛋糕品牌琳琅满目,有元祖、皇冠蛋糕等等,申请人在进行蛋糕品牌的选择时,先看品牌大小,再看加盟费用,名气大的...。

人们对机器人的抓取和操作存在很多误解,很多研究成果很难推进到实际应用环节,武汉大学李淼教授介绍,这是他放弃前往麻省理工MCubeLab,操纵与机制实验室,AlbertoRodriguez教授团队做博士后研究,选择回国创业的重要原因,李淼教授博士毕业于瑞士洛桑联邦理工学院,师从学习算法与系统实验室的创办者AudeBillard教授,...。
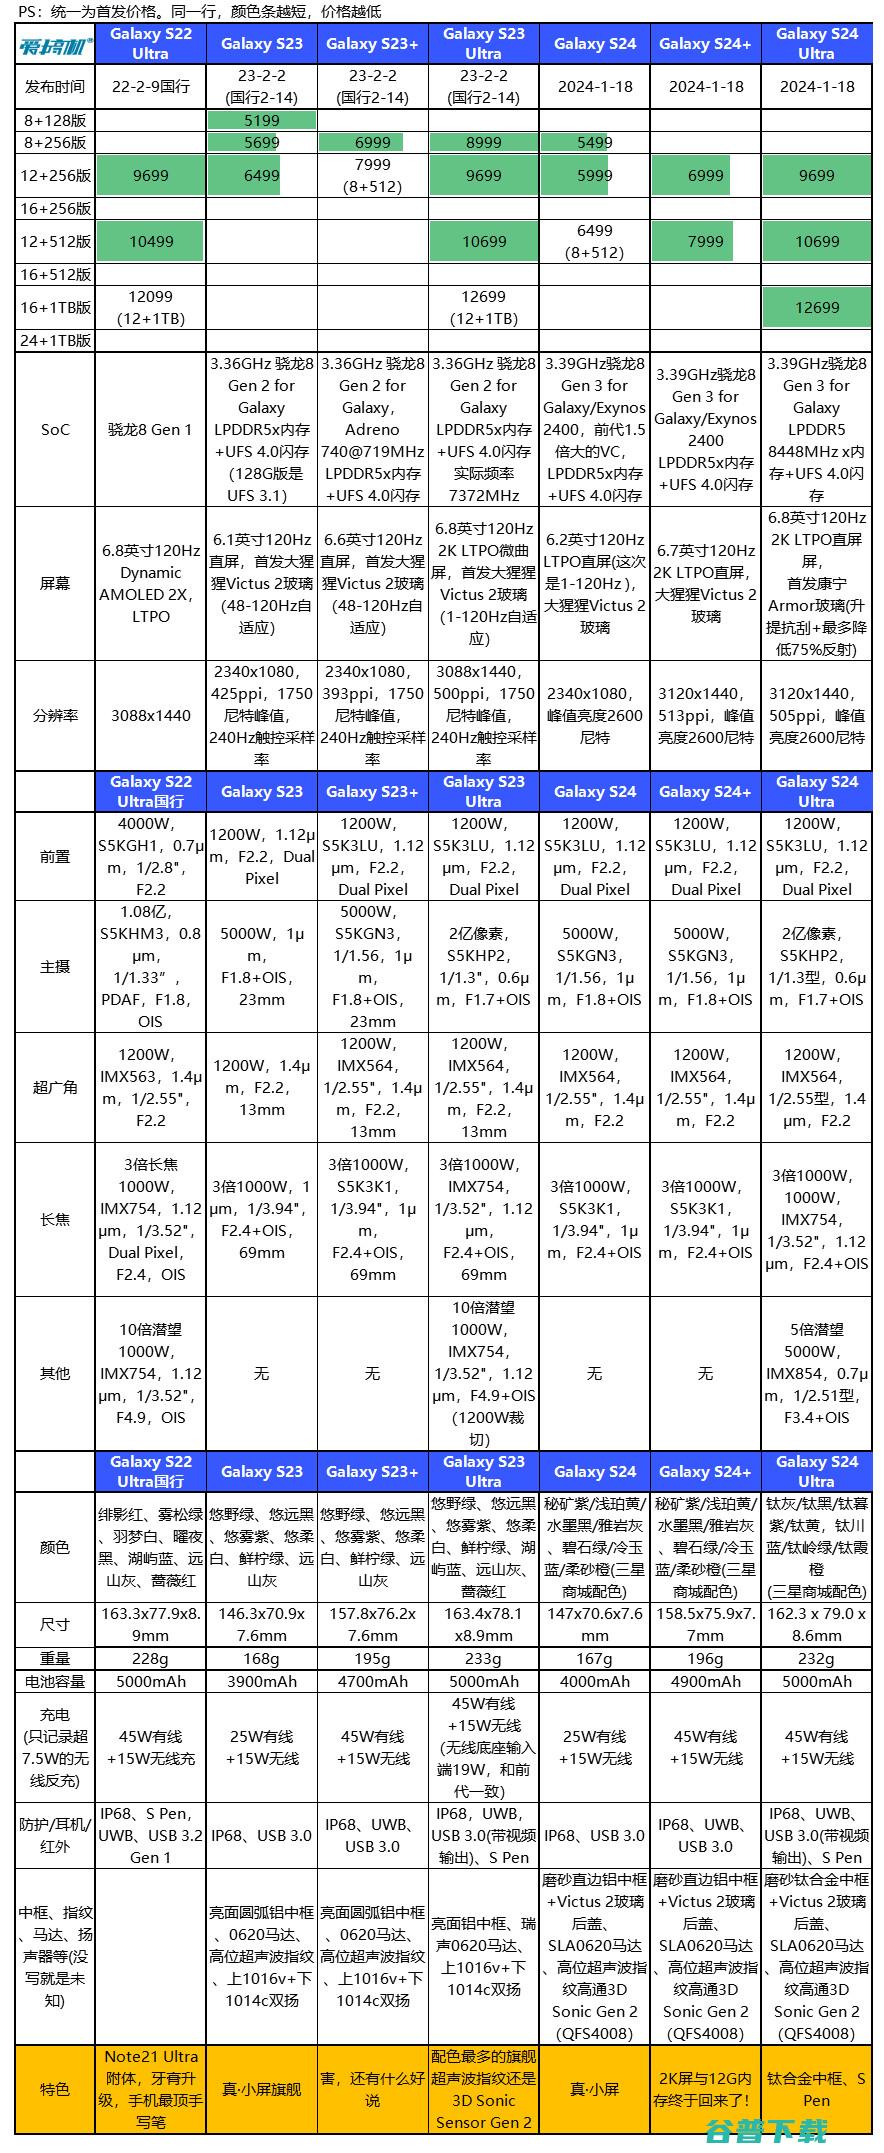
三星GalaxyS24系列国行版在1月25日晚发布,我们在发布会现场做了简单的外观和拍照对比,现在了看一下,开波先对比一下旗舰们,GalaxyS24,没什么好说的,正宗的小屏旗舰,就是在有12,256的情况下,往上一档竟然是8,512,这设定有亿点迷,这一代的屏幕大了0.1英寸,借用一下小白测评的图↓今年GalaxyS24,有大幅升级...。

校园暴力在学校一直屡禁不止,不仅对很多学生的身体上造成伤害,也在他们的心理上留下阴影,如果一直处于这种压抑的状态,这些学生很可能会承受不了,从而选择做出一些极端的行为,在陕西西安就有一名高三女生从4楼教室跳楼自杀,而这件事情也在网上引起热议,这么一个年轻的生命就这样悄然离世,当地警方接到报警之后也迅速介入此事,从现场的视频可以看出,坠...。

发表在峰米投影仪2021,5,713,37峰米激光电视C2是一款性价比高的超短焦投影设备,内置FengOS操作系统,支持下载第三方应用软件,可以在线观看电视直播,具体峰米激光电视C2怎么看直播,下面就分享最新的操作方法,一、准备工作1.峰米激光电视C2一台;2.峰米遥控器一个;3.U盘一个,二、峰米激光电视C2怎么看直播方法一,1.在...。

1、梦见父亲出现车祸的吉凶指数基础安泰,得贵人助力,而在困难之中得安康开展,但成功运之性能不良,难于伸张,故然只是色厉内荏而已,虽苦闷烦恼殊多,但大体可得安康,衣食短缺,幸福有寿,人地两格,无凶数,则身材肥壮,疾病少有,有病吃药即可速愈,中吉,吉凶指数,98,仅供参考,2、梦见父亲出现车祸的宜忌,宜,宜晒太阳,宜穿白色衣物,宜延迟起...。
environment英[ɪnˈvaɪrənmənt]美[ɛnˈvaɪrənmənt,ˈvaɪən,]n.环境,外界,周围,围绕,上班平台,运转,环境双数,environments形近词,entironment1TheplanswillbeexaminedbyEUenvironmentministers.欧盟各国环境部部长将细心钻...。

白酒专家品鉴四特十五年:名瓷盛老酒自用送人两相宜

风靡今夏的"多巴胺穿搭"背后有何玄机,多巴胺,受体,递质,血清素,神经元,脑细胞

随着人们生活水平的不断提高和生活节奏的加快,现在饮食与健康越来越受到消费者们的关注,健康饮食已经成为主流,人们不仅要口感上的享受也追寻身心上的健康,铁锅炖牛排正式随着这一股风席卷,很多的加盟商看到了这个商机选择加盟,今天小编就给大家介绍一下铁锅炖牛排加盟怎么样,那么铁锅炖牛排怎么样呢,首先就是智慧之选灵活,量身打造为客户量身打造档口店...。

目前情况来,杭州来女士被杀案已经破案,来女士的丈夫许某某面对铁一样的事实面前,也已经不得不认罪伏法,他亲口承认,是自己趁妻子熟睡时,将其杀害并分尸抛至于化粪池,从警方的通报当中也能够看出,许某某是因为家庭矛盾激发而对妻子来女士痛下杀手,而且,这起案件系许某某预谋作案,许某某交代,案发当日凌晨,许某某在杭州市江干区三堡北苑家中,趁妻子来...。

我购置的大疆Air3无人机航行器产品在保修期内,同时购置了大疆的随心换保险也在保险期内,6月20日无人机航行器产品发消费质量量疑问缺点#在智能返航环节中出现定位偏向,同时避障系统失灵,就在眼前自行撞楼坠机,经大疆公司启动航行数据飞析后确认是产品疑问造成的损坏,不是人为造成,自己在出事今天按大疆需要......。

[全球网报道记者姜蔼玲]韩国,中央日报,11日报道称,正在华盛顿加入北约峰会的韩国总统尹锡悦外地期间10日与乌克兰总统泽连斯基会面,韩国国度安保室当日举行资讯颁布会,称将为乌克兰及其国民提供所需声援,此信息经韩媒报道后,引发不少韩国网友不满,有网友称,,此举,令人寒心,,非要四处抚慰抗争迸发吗,报道称,今日晚宴前,尹锡悦夫妇和泽连...。

H5游戏平台有风林手游平台福利手游APP平台首选风林手游风林手游平台,是专为玩家打造的手机游戏平台,以玩家为核心提供新的精品手游、超全的礼包、超多的福利,可间接支付的抵扣券对新人玩家很是友好,咱们努力成为受玩家喜欢的手机游戏经营平台,平台蕴含传奇,仙侠,卡牌,战略,三国,角色表演等各种类型,更有收费满级VIP、GM特权等抢手BT手游...。